Un exploitant de stockage de gaz : piloter la maintenance prédictive sur deux compresseurs, pas sur toute la flotte
Une mauvaise maintenance peut coûter 5 % à 20 % de capacité à un actif, et les programmes prédictifs matures annoncent 30 % à 50 % d'arrêts en moins. Un exploitant de stockage de taille moyenne doit commencer par deux compresseurs critiques avec une référence, pas par toute la flotte.
À retenir
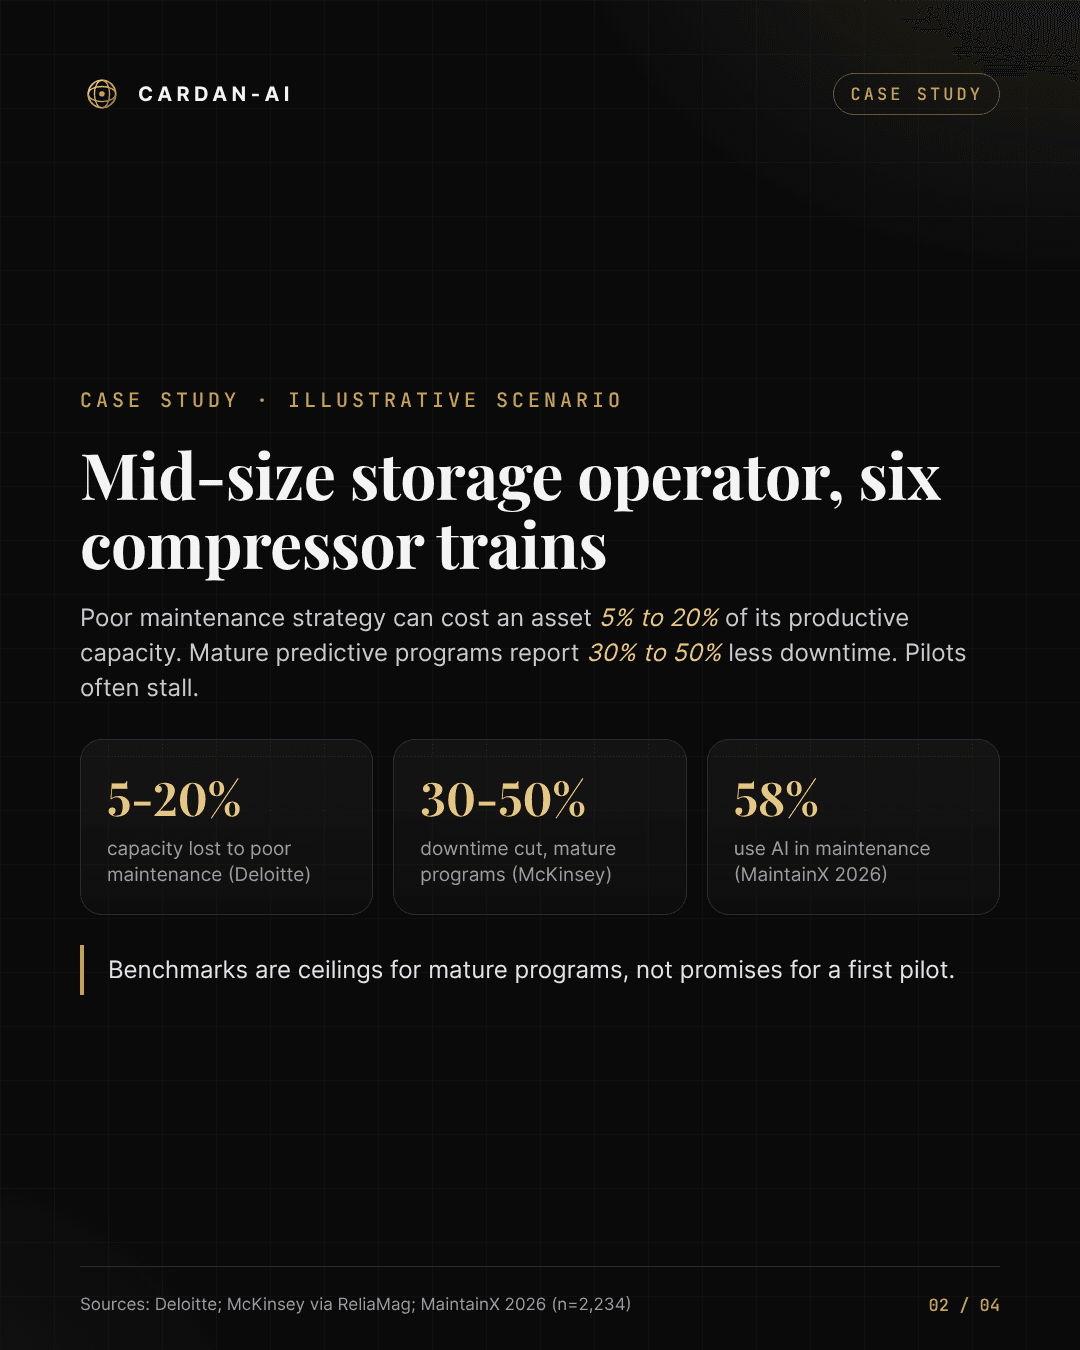
- Une mauvaise stratégie de maintenance peut réduire de 5 % à 20 % la capacité productive d'un actif (Deloitte).
- Les programmes prédictifs matures annoncent 30 % à 50 % d'arrêts en moins (McKinsey, via ReliaMag) ; les premiers pilotes restent en dessous.
- 58 % de 2 234 responsables maintenance interrogés utilisent déjà l'IA (MaintainX, 2026) : l'adoption n'est pas le frein.
- Le succès tient à un responsable, une référence et des droits de décision échelonnés.
Les sites de stockage et de compression de gaz exploitent un petit nombre de machines tournantes de grande valeur. Quand un train de compression s'arrête sans prévenir pendant une fenêtre d'injection ou de soutirage, le coût est de la capacité perdue, pas seulement une réparation. Ce scénario décrit un exploitant illustratif à six trains de compression ; ce n'est pas une entreprise réelle.
Deloitte indique que de mauvaises stratégies de maintenance peuvent réduire de 5 % à 20 % la capacité productive d'un actif et que les arrêts non planifiés coûtent environ 50 Md$ par an à l'industrie. C'est l'ordre de grandeur de l'enjeu pour un actif capitalistique.
Les benchmarks compilés par ReliaMag indiquent que les programmes prédictifs matures réduisent typiquement les arrêts machine de 30 % à 50 % (McKinsey, 2017), et citent 5 % à 10 % de coûts de maintenance en moins et 10 % à 20 % de disponibilité en plus (Deloitte). La même revue note que les premiers pilotes, avec des modèles bruités, restent en général en dessous, et que certains chiffres très répétés remontent à des documents de fournisseurs.
Le mécanisme économique est le coût de l'erreur dans les deux sens. Une panne manquée coûte de la capacité et parfois de la sécurité ; une fausse alerte coûte une intervention planifiée et du temps d'ingénieur. Un modèle ne crée de la valeur que si la qualité de ses alertes dépasse le calendrier préventif actuel, ce qui ne se mesure que face à une référence enregistrée.
L'adoption n'est pas le goulot. L'enquête MaintainX 2026 auprès de 2 234 responsables maintenance et exploitation indique que 58 % utilisent l'IA en maintenance, et que 75 % des adopteurs déclarent un retour en moins de six mois. La même source cite le manque de personnel, l'intégration aux systèmes existants et la résistance culturelle comme principaux obstacles.
Pour l'exploitant, la séquence compte plus que l'outil. Deloitte recommande de commencer par la maintenance préventive et centrée sur la fiabilité, puis de piloter sur un ou deux actifs essentiels à l'exploitation, avec assez d'historique pour bâtir une référence. Les actifs pilotes doivent être ceux où un seul arrêt évité finance le programme.
Les implications varient selon les acteurs. Les directeurs de site ont besoin d'une règle de décision hebdomadaire, pas d'un tableau de bord. Les ingénieurs fiabilité doivent piloter le tri des alertes et garder le droit de passer outre. La finance doit valider la référence avant le pilote, pour éviter de débattre des gains après coup. La DSI sécurise les flux de données d'exploitation ; le fournisseur se choisit en dernier.
Limites : la fourchette 30 % à 50 % vient de programmes matures et d'une source de 2017, et une revue juge de faible confiance certaines allégations de réduction des pannes. Un premier pilote peut n'en livrer qu'une fraction, voire rien, si la qualité des données est mauvaise. Ces benchmarks sont un plafond à tester, pas une prévision à engager.
Cas d'école
Exploitant illustratif de stockage de gaz de taille moyenne, six trains de compression, soumis à une demande saisonnière d'injection et de soutirage.
Enjeu : Les arrêts non planifiés de compresseurs en période de pointe coûtent de la capacité, et la maintenance est calendaire : certaines interventions arrivent trop tôt, d'autres trop tard.
5-20%
capacité perdue par mauvaise maintenance (Deloitte)
30-50%
arrêts en moins, programmes matures (McKinsey via ReliaMag ; plafond, pas promesse)
58%
des responsables maintenance utilisent déjà l'IA (MaintainX 2026)
Démarche
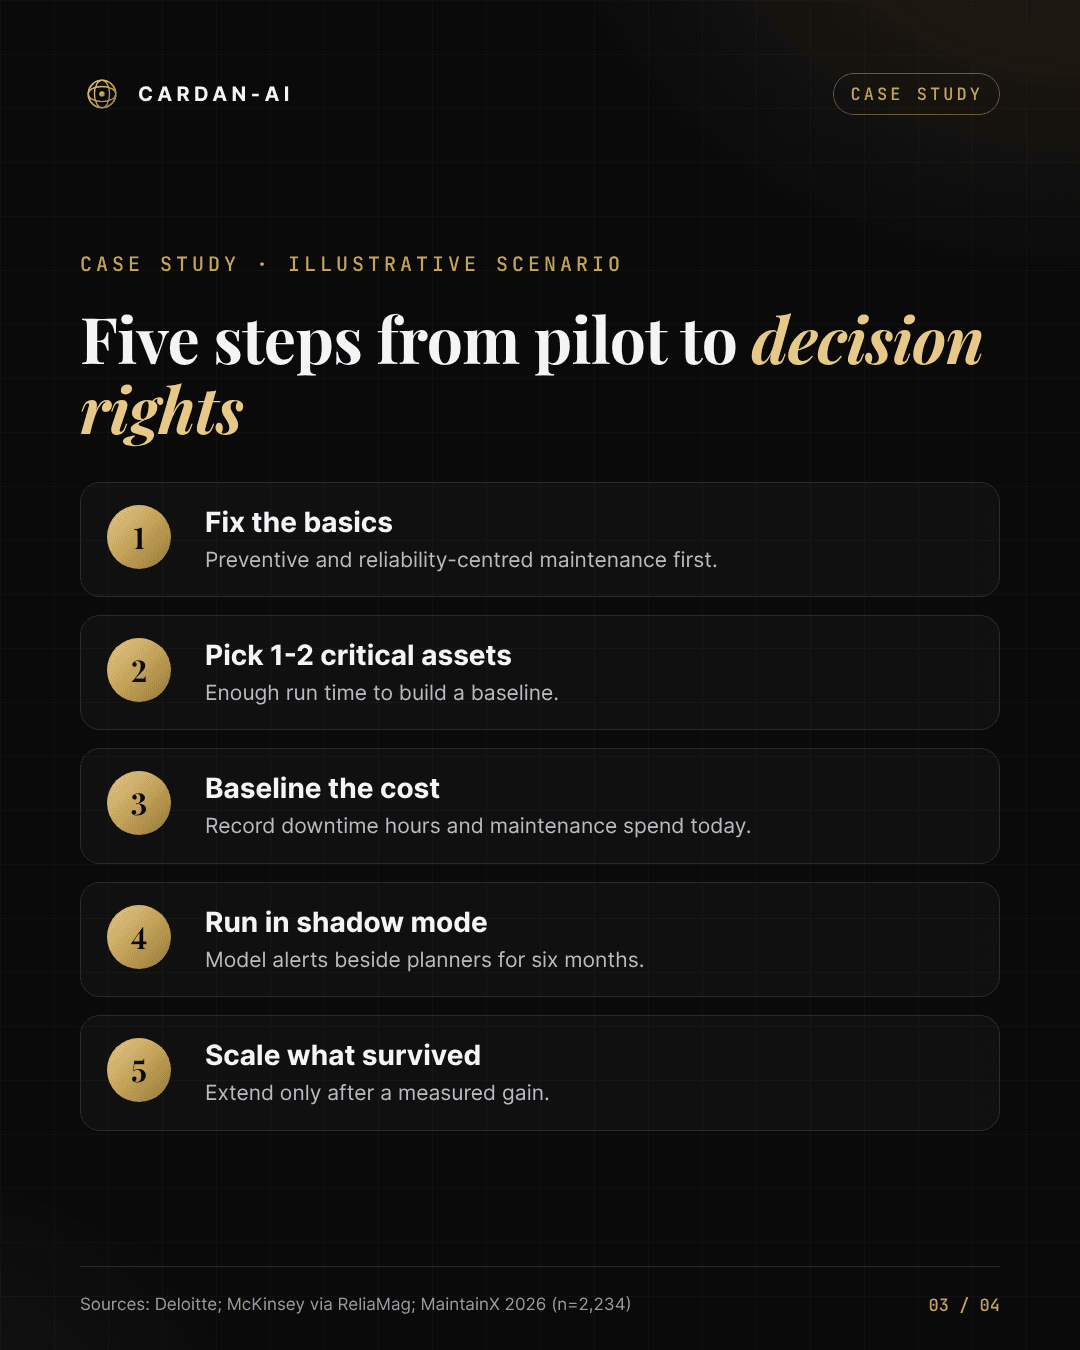
- 1.Réparer d'abord les bases préventives et de fiabilité sur les unités pilotes.
- 2.Sélectionner un ou deux compresseurs critiques avec un long historique.
- 3.Enregistrer 12 mois d'heures d'arrêt et de dépenses de maintenance comme référence.
- 4.Faire tourner le modèle en mode ombre à côté des planificateurs pendant six mois.
- 5.Accorder les actions déclenchées par alerte par étapes et étendre seulement après un gain mesuré.
Le pilote se joue avant tout modèle : un responsable, une référence, le mode ombre, et des droits de décision accordés seulement après un gain mesuré.
Cas d'école construit à partir de benchmarks publics et de l'expérience sectorielle de Cardan-AI ; les ordres de grandeur sont sourcés ci-dessous.
Nos recommandations
- 1
Nommer une classe d'actifs et un responsable
Choisir les deux compresseurs aux arrêts non planifiés les plus coûteux et nommer un responsable fiabilité. Écrire la décision comme une question hebdomadaire : quelle unité exige une intervention dans les 30 jours ?
- 2
Réparer d'abord les bases préventives
Deloitte conseille de commencer par la maintenance préventive et centrée sur la fiabilité. Clore les ordres de travail ouverts et les trous de capteurs sur les unités pilotes avant d'entraîner un modèle.
- 3
Enregistrer la référence
Relever heures d'arrêt non planifié, dépenses de maintenance et consommation de pièces sur 12 mois. Sans cela, aucun gain n'est mesurable.
- 4
Tourner en mode ombre six mois
Laisser le modèle signaler les risques à côté du jugement des planificateurs. Comparer taux de détection et fausses alertes à la référence ; ne changer aucun processus.
- 5
Échelonner les droits de décision
N'autoriser les interventions déclenchées par alerte qu'une fois la référence battue. Garder les décisions de sécurité et de remise en service aux ingénieurs qualifiés.
Analyse publiée par
Cardan-AI Intelligence
Notre cellule de recherche et d'analyse, dédiée à l'IA appliquée à l'entreprise, à l'industrie et à la conformité réglementaire.
Parlons de votre prochaine longueur d'avance
Trente minutes pour identifier, dans vos opérations, les deux ou trois cas d'usage qui se financent d'eux-mêmes la première année.